大四上 Week 1
AI医学
Bilibili:BV1saLfz8Ev1
原文:Artificial Intelligence–Based Multimodal Risk Assessment Model for Surgical Site Infection
医疗报告可结合AI预测预后
病理报告(TCGA or 自己医院)
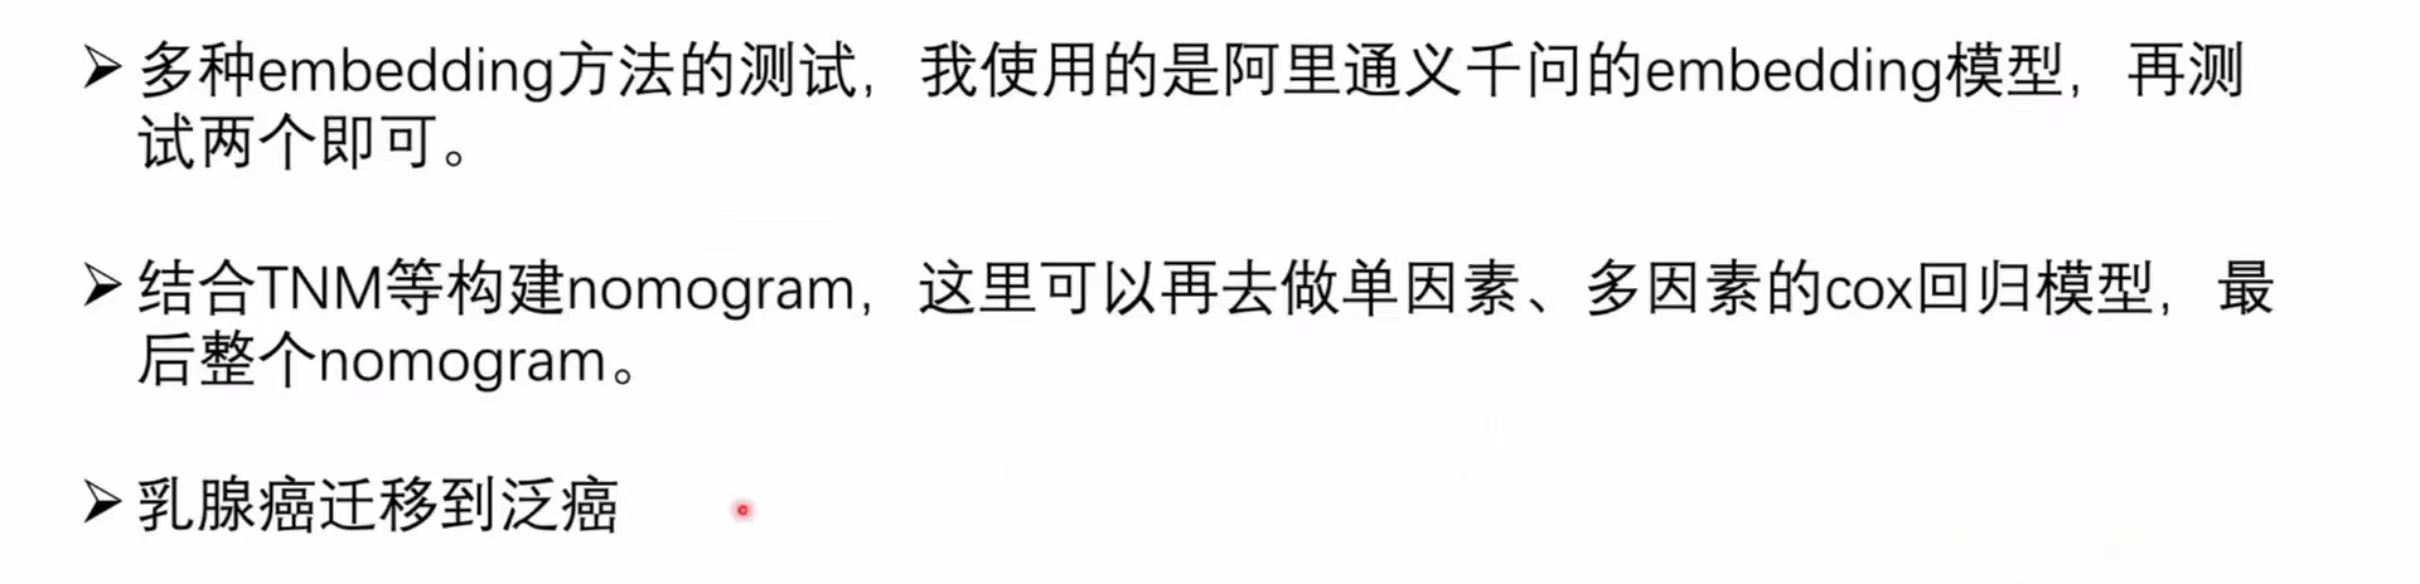
长文本,比较dirty,大语言模型(提取可判定信息,embedding成为一个统一大小的特征空间)。做预后,cox回归......
抛去之前的提取信息,直接LLM+文本,预测。
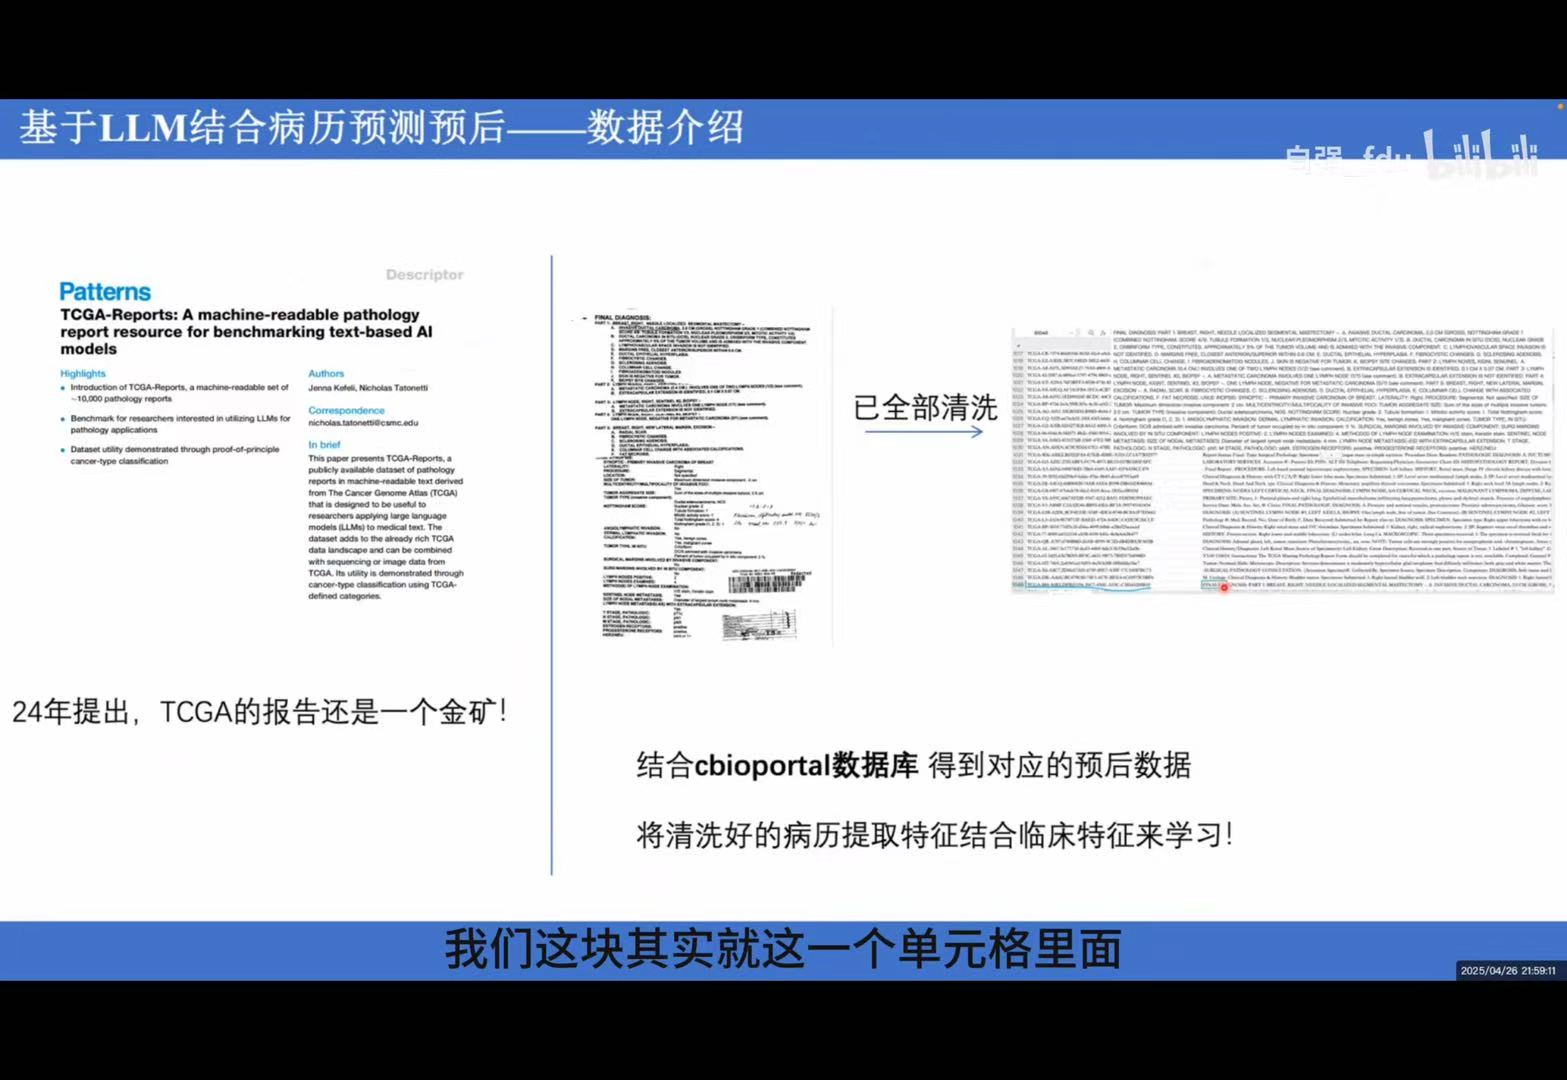
layer=MLP=多层感受器。后面得到一个risk score(作为biomarker,分组)。以及在cbioportal里面得到的生存信息/预后信息,构建一个cox,得到后续临床指标(AUC, KM)。
五折交叉验证:单中心的,1033个病人,拆分成5份,每次取4份训练,另1份测试。来回倒腾5次。得到c-index,取个平均值,体现方法有效性。
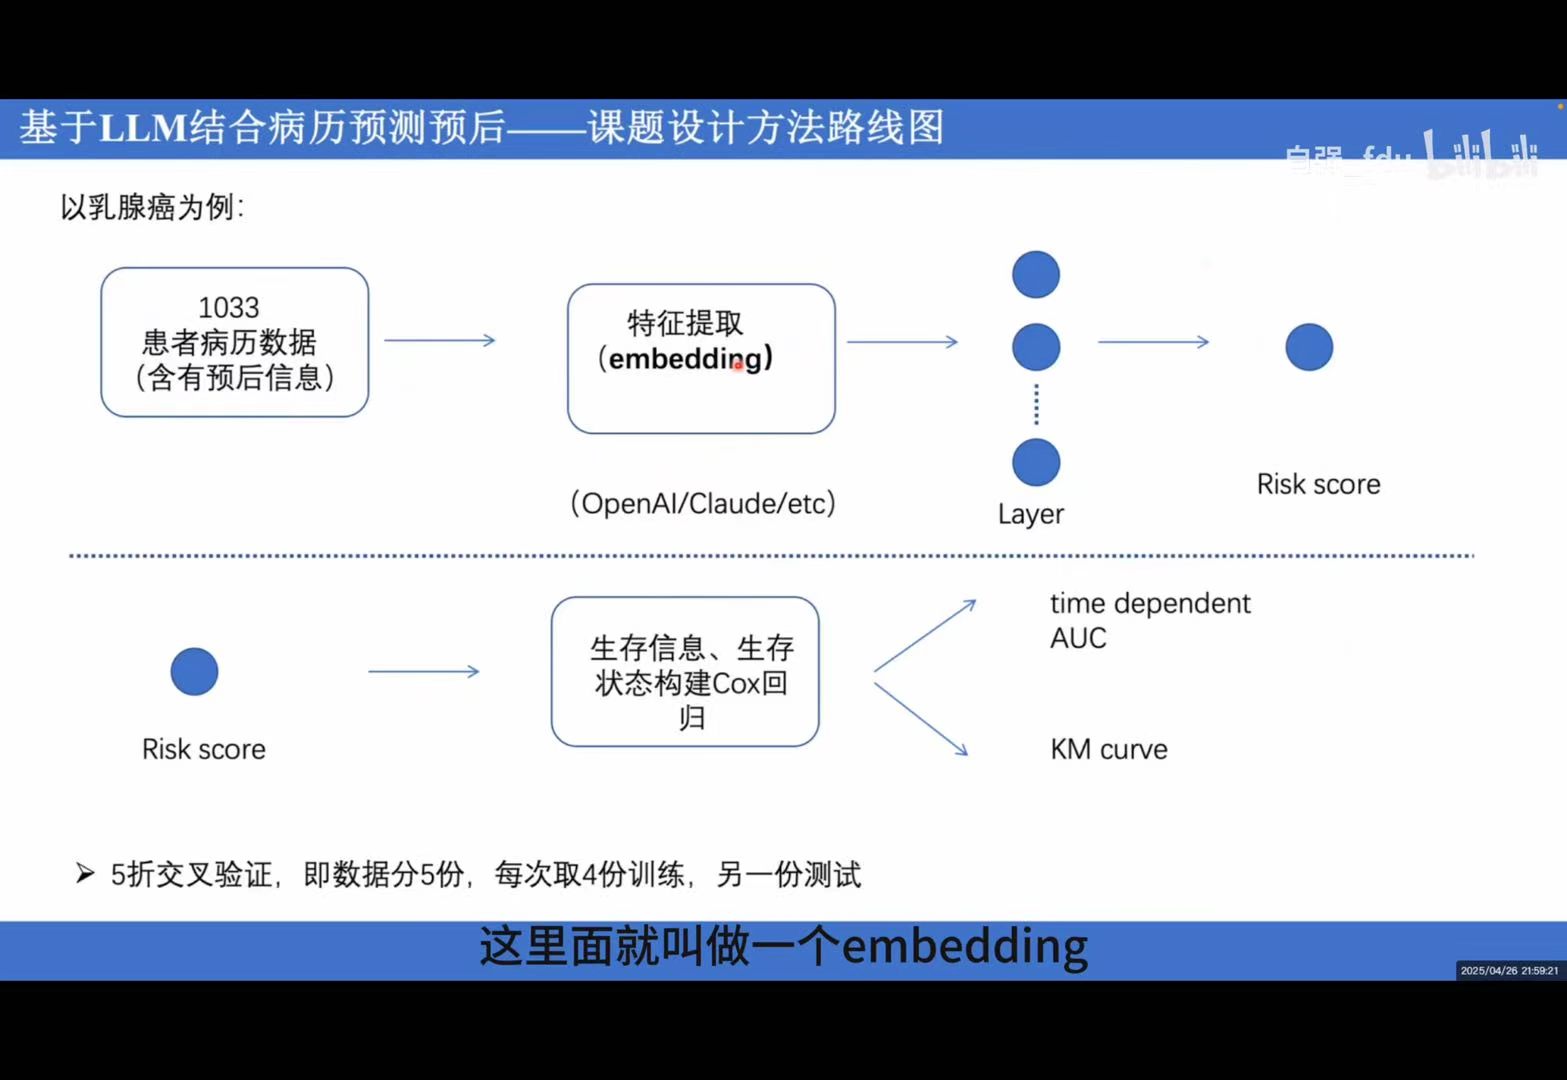
什么叫embedding
比如计算机中,要表示颜色(one-hot编码)。数组中的不同位置代表不同颜色,数据量极大。
如果要数据压缩,如RGB表示方法,参数空间小很多。
但是embedding过程中是可以学到语义的,在向量上的距离可比较。有点像聚类的过程。
UMAP和单细胞是个无监督的过程。
作者锐论:
病理科不配合的情况下,就拉病理报告,pseudo pathology information branch
影像科不配合,拉影像报告,pseudo radiology information branch
你不能说这部分不是病理或者影像的特征,它只是用报告来存的
优选评论:
有位老师说自己在2020年发表的JMIR文章,也使用这个思路,直接把报告文本转成embedding加上结构化的检验结果预测术后感染。我找到原文开始拜读:
标题:Artificial Intelligence–Based Multimodal Risk Assessment Model for Surgical Site Infection (AMRAMS): Development and Validation Study
一、结论先行
原文输入是术前病程/手术计划类自由文本;
使用 fastText、CNN 和自注意力网络,而不是现代大语言模型;
结局是住院期间是否发生手术部位感染(SSI)的二分类,而不是带随访时间和删失的生存结局。
二、文章做了什么
2.1 数据与预测目标
单中心:RJ。
数据时间:2014-01-01 至 2019-06-30。
共纳入 21,611 份住院手术记录,其中 SSI 244 例,发生率 1.13%。
2018-07-01 以前的 17,597 例作为开发集,之后的 4,014 例作为时间留出测试集。
目标是在术前预测患者住院期间是否发生浅表切口、深部切口或器官/腔隙 SSI。
阳性标签由医院感染防控部门在出院后通过病历审查确定。
需要注意:原文把后期时间留出集称作“external validation”,但数据仍来自同一家医院。按当前预测模型术语,它更准确地属于时间验证(temporal validation),而不是独立地域/机构外部验证。
2.2 输入变量
结构化变量包括人口学信息、术前住院日、血常规、凝血、肝肾功能、电解质、吸烟、婚姻、急诊手术和麻醉类型等。论文称模型使用了 47 个客观变量。
非结构化输入是术****前记录的自由文本部分,通常包含术前诊断、拟行手术名称、手术指征、并发症及预防措施。因此,把它概括成“报告文本”尚可。
2.3 文本如何变成固定长度向量
- 以中文维基百科约 4.1 GB 文本和一个中文医学百科约 96.9 MB 文本训练 fastText。(2020年的常见方案,现在技术上已经落后。)
现在重新训练 fastText 没多少意义。做TCGA可直接用embedding API;做本院病历,优先部署本地医学/中文embedding模型。
- 用 Jieba 和医学词典分词,得到每个词 128 维的 embedding。
Jieba分词:中文没有天然空格,把“结肠恶性肿瘤切除术”切成“结肠 / 恶性肿瘤 / 切除术”。医学词典用于防止把专业术语切碎。
查词向量:把每个词转换成128个数字。例如一份报告有200个词,就得到一个
200 × 128的矩阵。
现在调用现代embedding模型时,分词和向量生成已由模型内部自动完成,通常不需要自己用Jieba。手动Jieba是fastText时代的必要步骤,不是当前LLM embedding方案的必需步骤。
对传统机器学习模型,将一份记录中所有词向量按每个维度做最大池化,得到统一的 128 维文档向量。
将该文档向量与结构化变量直接拼接,再输入 LASSO Logistic、随机森林或 GBDT。
它们都是拿“文本 embedding+检验指标”预测是否感染的分类模型:
LASSO Logistic:带自动筛选变量的逻辑回归。简单、可解释,适合做基线。
随机森林:许多决策树投票。能处理非线性,但容易学到数据中的捷径。
GBDT:一棵树接一棵树纠错。表格数据上通常比随机森林更强。
Embedding模型:只负责把报告转换成一串数字,例如768维向量。
LASSO Logistic、随机森林、GBDT:负责根据这些数字预测“会不会感染”。
Cox模型:负责根据这些数字预测生存或复发风险
- 深度学习方案则让 CNN 或 Bi-LSTM + 自注意力对词向量序列进行端到端编码,再与结构化变量融合。
LASSO/RF/GBDT:先人为压缩文本,再预测。
CNN/Bi-LSTM:一边学习怎样理解文本,一边学习怎样预测。
细说:
CNN:从词序列中抓局部短语,例如“恶性肿瘤”“结肠切除”。
Bi-LSTM+自注意力:结合上下文和词序,重点关注与风险相关的内容。
LASSO Logistic、随机森林、GBDT:不能直接理解词序列,必须先把整份报告压缩成固定的128维向量,再进行预测。
2.4 主要结果
在内部验证中,LASSO、随机森林和 GBDT 加入文本 embedding 后的 AUROC 均高于不含文本的对应模型。
2.5 对今天研究设计仍有启发的地方
设置“结构化变量模型”与“结构化变量 + 文本模型”的直接消融比较;
仅使用预测时点以前已经存在的数据;
对高度不平衡结局采用合适的损失权重并报告不只一种性能指标;
分析文本贡献,而不仅把神经网络当作不可解释黑箱;
使用日常病历自动抽取,减少人工整理负担。
2.6 原文的重要局限
只有单中心时间验证,没有真正的跨医院外部验证;
SSI 随访仅限住院期,出院后感染可能被漏标;
变量缺失率最高超过 70%,且“是否缺失”本身成为重要预测信号,模型可能学习到医生检查行为;
SSI 事件只有 244 个,深度模型的稳定性和校准仍需谨慎评价;
文本中的手术名称、部位等可能是强代理变量,不能据此认为模型发现了新的生物学机制;
主要报告 AUROC,未充分回答概率校准、决策效益及跨机构泛化问题。
三 TCGA + 病理报告 embedding + 生存模型
HONeYBEE 已在 11,400 余名 TCGA 患者、33 个癌种上,将结构化/非结构化临床数据、病理报告、影像和分子数据转换为基础模型 embedding,并用 CoxPH、随机生存森林和 DeepSurv 等评估总生存预测。它与“统一大小特征空间 + 多模态融合 + 生存预测”高度重合。
Tripathi A, et al. HONeYBEE: enabling scalable multimodal AI in oncology through foundation model-driven embeddings. npj Digital Medicine. 2025;8. DOI: 10.1038/s41746-025-02003-4. PMID: 41131352.
四 LLM 直接阅读 TCGA 病理报告并做 Cox
2026 年 SCRIPT 研究使用开源 LLaMA 3.3 70B 直接阅读 TCGA 的结直肠癌、胃癌和肝癌完整病理报告,输出高/低风险及理由,并使用 Kaplan–Meier 和多变量 Cox 分析 OS、PFS、DSS。结直肠癌中,LLM 风险分组与 OS、PFS 和 DSS 均显著相关;但其输出主要是二元风险分组,而不是保留全部连续 embedding。
Loeffler CML, et al. SCRIPT: Stratified clinical risk prediction from pathology reports using large language models. Journal of Pathology Informatics. 2026;22:100673. DOI: 10.1016/j.jpi.2026.100673. PMID: 42281755.
科研怪谈
1 不会讲文献怎么办?
科学问题是啥,用了什么数据,多大规模,当前方法是啥,结果怎么样,局限在哪?
--陈老师(复旦大学眼耳鼻喉医院)
讲文献讲究一个避重就轻。
--胡老师(中南大学湘雅二医院)
2 吃饭太快会导致肥胖吗?
Codex给我推荐了这篇文献:Eating quickly is positively associated with excess body weight.
Ohkuma, T., Hirakawa, Y., Nakamura, U. et al. Association between eating rate and obesity: a systematic review and meta-analysis. Int J Obes 39, 1589–1596 (2015). https://doi\.org/10\.1038/ijo\.2015\.96
所以最好的解决方法:在食堂边吃饭边玩手机以降低进食速度。